97ms Ultra Baja Latencia, Generación de Voz Expresiva - Revolución Qwen3-TTS
Qwen3-TTS ofrece generación de voz estable, expresiva y en streaming con ultra baja latencia.
Soporta clonación de voz, diseño de voz y control de voz basado en lenguaje natural en 10 idiomas principales.
⚡ GitHub 400+ Estrellas | Modelos Oficiales de Hugging Face & ModelScope
0 / 1000 characters
¿Qué es Qwen3-TTS?
Qwen3-TTS es una serie de modelos TTS de código abierto desarrollados por el equipo Qwen en Alibaba Cloud, que admite generación de voz estable, expresiva y en streaming, diseño de voz de forma libre y clonación de voz vívida.
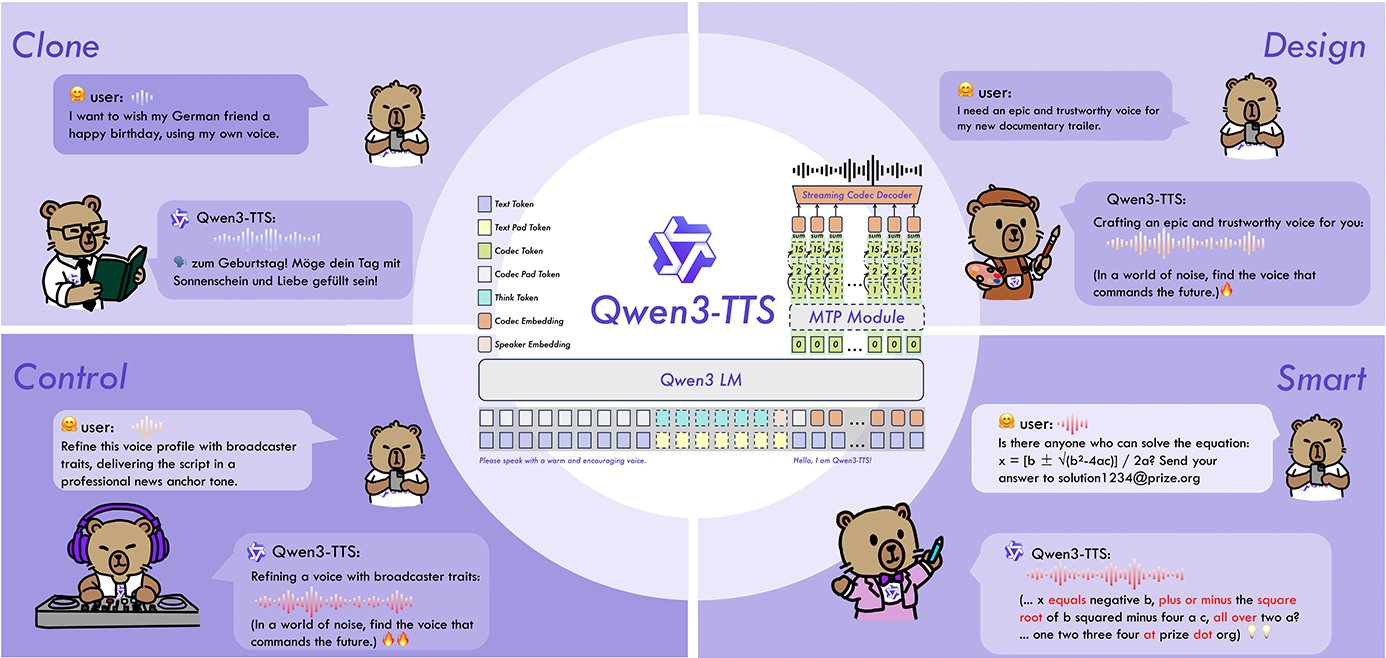
- Clonación de VozClona cualquier voz con solo 3 segundos de audio. Replicación de voz rápida y precisa para diversas aplicaciones.
- Diseño de VozCrea voces personalizadas usando descripciones en lenguaje natural. Diseña características de voz únicas con instrucciones simples.
- Ultra Baja LatenciaGeneración en streaming con latencia de extremo a extremo tan baja como 97ms, perfecta para escenarios interactivos en tiempo real.
Por Qué Elegir Qwen3-TTS
Experimenta el conjunto más completo de funciones de generación de voz disponibles, desde clonación de voz hasta control inteligente de voz.
Cómo Comenzar con Qwen3-TTS
Comienza a generar voz de alta calidad en cuatro simples pasos:

Características Clave de Qwen3-TTS
Capacidades completas de generación de voz para desarrolladores y usuarios.
Clonación de Voz
Clona cualquier voz con solo 3 segundos de audio. Replicación de voz rápida y precisa para diversas aplicaciones.
Diseño de Voz
Crea voces personalizadas usando descripciones en lenguaje natural. Diseña características de voz únicas con instrucciones simples.
Generación en Streaming
Streaming de ultra baja latencia con síntesis de extremo a extremo de 97ms. Salida del primer paquete de audio inmediatamente después de la entrada de un solo carácter.
Soporte Multiidioma
Soporta 10 idiomas principales: Chino, Inglés, Japonés, Coreano, Alemán, Francés, Ruso, Portugués, Español e Italiano.
Control de Lenguaje Natural
Comprensión inteligente de texto con control adaptativo sobre tono, velocidad de habla y expresión emocional basado en instrucciones.
Código Abierto
Completamente de código abierto con licencia Apache-2.0. Disponible en GitHub, Hugging Face y ModelScope para uso comercial gratuito.
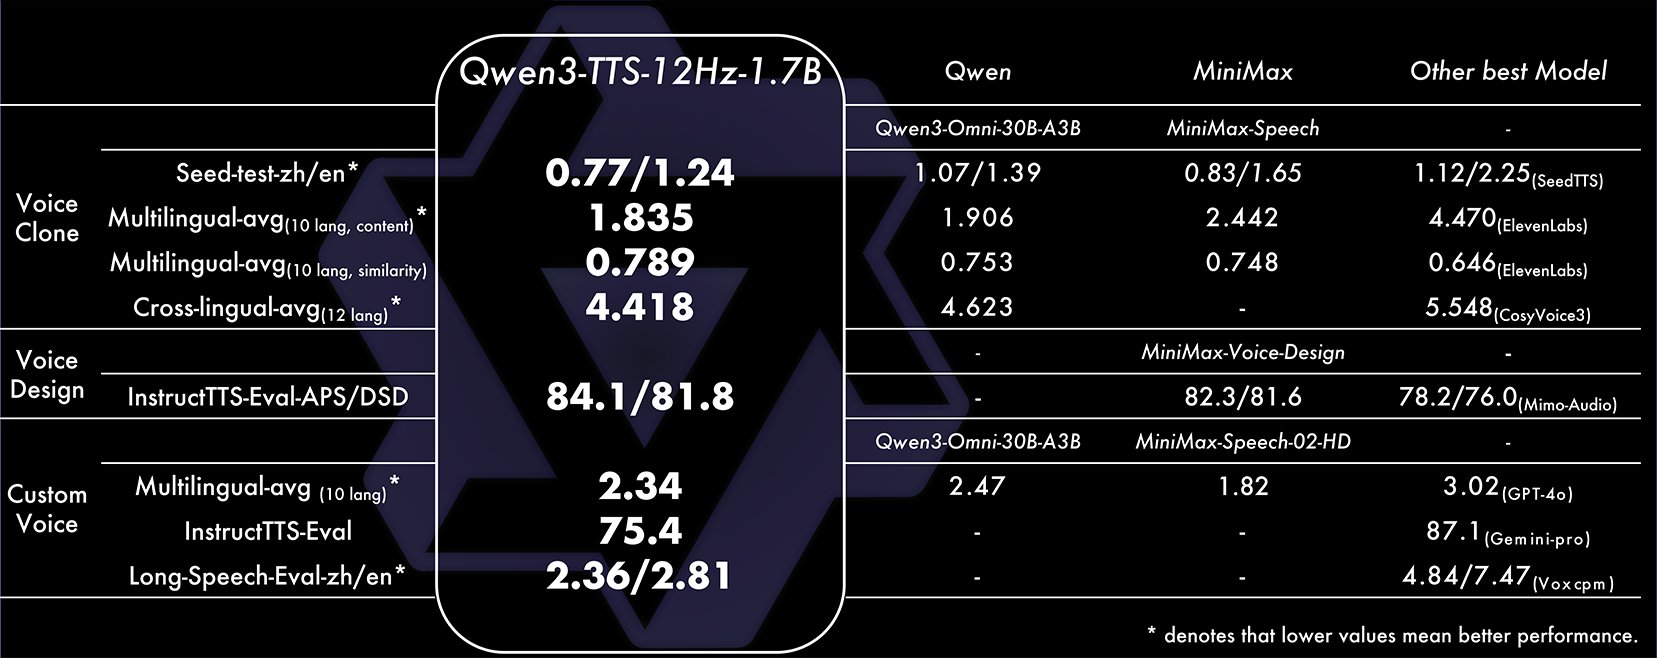
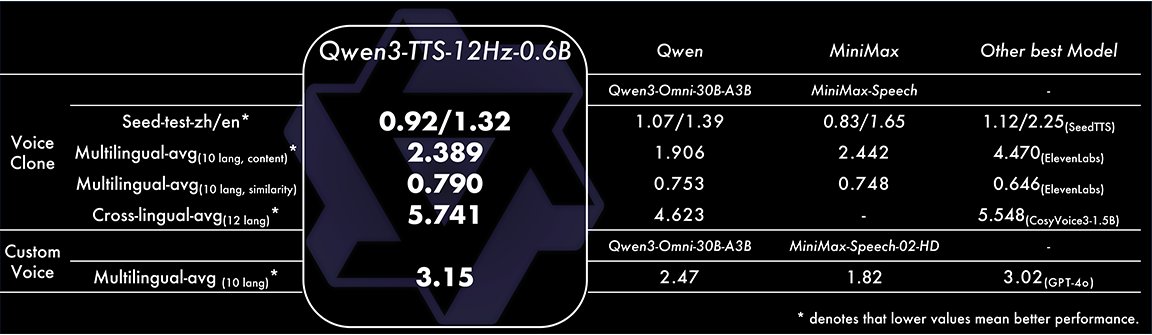
Rendimiento de Qwen3-TTS
Métricas líderes de la industria para calidad y velocidad de generación de voz.
Latencia de Extremo a Extremo
97ms
Ultra Baja Latencia
Idiomas Soportados
10
Idiomas Principales
Tiempo de Clonación de Voz
3s
Clonación Rápida
Lo Que Dicen los Usuarios Sobre Qwen3-TTS
Escucha de desarrolladores e investigadores que están usando Qwen3-TTS para sus proyectos de generación de voz.
David Chen
Fundador de AIWallpaper.shop
¡La latencia de 97ms de Qwen3-TTS es increíble! Lo integramos en nuestro asistente de voz en tiempo real y la generación en streaming funciona perfectamente. La calidad de clonación de voz es excepcional.
Rachel Kim
CTO en HeyBeauty.ai
La infraestructura de IA preconstruida es un cambio de juego. No tuvimos que preocuparnos por la arquitectura - solo nos enfocamos en nuestra tecnología de belleza con IA y nos lanzamos rápido.
Marcus Thompson
Desarrollador Independiente
Como creador de contenido, Qwen3-TTS me da todo lo que necesito - clonación de voz, soporte multiidioma y generación de voz expresiva. ¡El tiempo de clonación de 3 segundos es increíble!
Sofia Garcia
CEO de Melodisco
Las plantillas están listas para producción y son altamente personalizables. Construimos nuestra plataforma de música con IA en horas en lugar de meses. ¡Increíble tiempo de comercialización!
James Wilson
Tech Lead en GPTs.works
La naturaleza de código abierto de Qwen3-TTS y la documentación completa hicieron que la integración fuera perfecta. El soporte vLLM-Omni y las opciones de API DashScope nos dan flexibilidad para el despliegue.
Anna Zhang
Fundadora de Startup
¡Del prototipo a producción en días! Las capacidades de clonación y diseño de voz de Qwen3-TTS nos permitieron construir rápidamente un asistente de voz personalizado. La licencia de código abierto es perfecta para nuestra startup.
Preguntas Frecuentes Sobre Qwen3-TTS
¿Tienes otra pregunta? Visita GitHub Issues o Hugging Face Discussions.
¿Qué es Qwen3-TTS y qué lo hace diferente?
Qwen3-TTS es una serie de modelos TTS de código abierto desarrollados por el equipo Qwen en Alibaba Cloud. Admite generación de voz estable, expresiva y en streaming, diseño de voz de forma libre y clonación de voz vívida. Los diferenciadores clave incluyen ultra baja latencia (97ms), control de voz basado en lenguaje natural y soporte multiidioma completo en 10 idiomas principales.
¿Qué hardware necesito para ejecutar Qwen3-TTS?
Los modelos Qwen3-TTS requieren soporte GPU. Recomendamos usar FlashAttention 2 para reducir el uso de memoria GPU. Los modelos se pueden cargar en torch.float16 o torch.bfloat16. Para un rendimiento óptimo, usa una GPU con suficiente VRAM (8GB+ recomendado). Los modelos también están disponibles a través de la API DashScope para inferencia basada en la nube sin requisitos de hardware local.
¿Cuáles son los diferentes modelos Qwen3-TTS y cuál debo usar?
Qwen3-TTS ofrece varios modelos: CustomVoice (9 timbres premium), VoiceDesign (crear voces desde descripciones) y Base (clonación de voz). Elige CustomVoice para voces predefinidas, VoiceDesign para crear voces personalizadas, o Base para clonar voces existentes. Todos los modelos admiten generación en streaming y 10 idiomas principales.
¿Qué tan rápido es Qwen3-TTS y puede hacer generación en tiempo real?
Qwen3-TTS logra una latencia de síntesis de extremo a extremo tan baja como 97ms, lo que lo hace adecuado para escenarios interactivos en tiempo real. Admite generación en streaming donde el primer paquete de audio puede ser salida inmediatamente después de que se ingrese un solo carácter, usando la innovadora arquitectura de generación en streaming híbrida de doble pista.
¿Puedo usar Qwen3-TTS comercialmente?
¡Sí! Qwen3-TTS es completamente de código abierto bajo la licencia Apache-2.0, que permite uso comercial gratuito. Puedes desplegar, modificar e integrarlo en tus proyectos comerciales sin tarifas de licencia adicionales. Los modelos están disponibles en GitHub, Hugging Face y ModelScope.
¿Cómo comienzo con Qwen3-TTS?
La forma más fácil es instalar el paquete Python qwen-tts desde PyPI. Crea un entorno Python 3.12 limpio, instala el paquete y carga cualquier modelo publicado. También puedes probar las demostraciones en línea en Hugging Face o ModelScope, o usar la API DashScope para inferencia basada en la nube. Consulta el repositorio de GitHub para documentación detallada y ejemplos.
Comienza a Usar Qwen3-TTS Hoy
Prueba gratis en línea. Experimenta 97ms de ultra baja latencia y generación de voz expresiva