97ms 초저지연, 표현력 있는 음성 생성 - Qwen3-TTS 혁명
Qwen3-TTS는 초저지연으로 안정적이고 표현력 있는 스트리밍 음성 생성을 제공합니다.
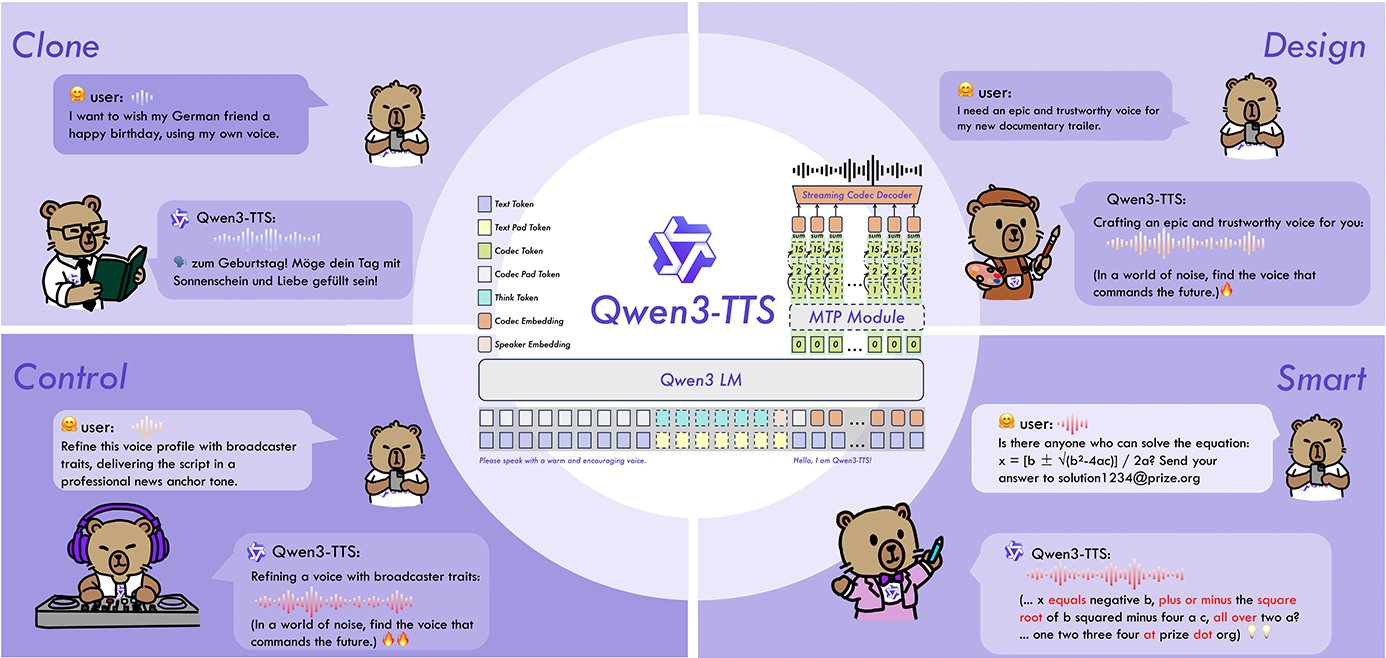
음성 복제, 음성 디자인 및 자연어 기반 음성 제어를 10개 주요 언어로 지원합니다.
⚡ GitHub 400+ 스타 | Hugging Face & ModelScope 공식 모델
0 / 1000 characters
Qwen3-TTS란 무엇인가요
Qwen3-TTS는 Alibaba Cloud의 Qwen 팀이 개발한 오픈소스 TTS 모델 시리즈로, 안정적이고 표현력 있는 스트리밍 음성 생성, 자유 형식 음성 디자인 및 생생한 음성 복제를 지원합니다.
- 음성 복제단 3초의 오디오로 모든 음성을 복제합니다. 다양한 애플리케이션을 위한 빠르고 정확한 음성 복제.
- 음성 디자인자연어 설명을 사용하여 사용자 정의 음성을 만듭니다. 간단한 지시로 고유한 음성 특성을 디자인합니다.
- 초저지연97ms의 엔드투엔드 지연으로 스트리밍 생성, 실시간 대화형 시나리오에 완벽합니다.
Qwen3-TTS를 선택해야 하는 이유
음성 복제부터 지능형 음성 제어까지 사용 가능한 가장 포괄적인 음성 생성 기능 세트를 경험하세요.
Qwen3-TTS로 시작하는 방법
네 가지 간단한 단계로 고품질 음성을 생성하세요:

Qwen3-TTS의 주요 기능
개발자와 사용자를 위한 포괄적인 음성 생성 기능.
음성 복제
단 3초의 오디오로 모든 음성을 복제합니다. 다양한 애플리케이션을 위한 빠르고 정확한 음성 복제.
음성 디자인
자연어 설명을 사용하여 사용자 정의 음성을 만듭니다. 간단한 지시로 고유한 음성 특성을 디자인합니다.
스트리밍 생성
97ms 엔드투엔드 합성으로 초저지연 스트리밍. 단일 문자 입력 후 즉시 첫 번째 오디오 패킷 출력.
다국어 지원
10개 주요 언어 지원: 중국어, 영어, 일본어, 한국어, 독일어, 프랑스어, 러시아어, 포르투갈어, 스페인어 및 이탈리아어.
자연어 제어
지시에 따라 톤, 말하기 속도 및 감정 표현에 대한 적응형 제어가 있는 지능형 텍스트 이해.
오픈소스
Apache-2.0 라이선스로 완전히 오픈소스입니다. 무료 상업적 사용을 위해 GitHub, Hugging Face 및 ModelScope에서 사용 가능.
Qwen3-TTS 성능
음성 생성 품질 및 속도를 위한 업계 최고의 지표.
엔드투엔드 지연
97ms
초저지연
지원 언어
10
주요 언어
음성 복제 시간
3초
빠른 복제
사용자들이 Qwen3-TTS에 대해 말하는 것
음성 생성 프로젝트에 Qwen3-TTS를 사용하는 개발자와 연구원의 이야기를 들어보세요.
David Chen
AIWallpaper.shop 창업자
Qwen3-TTS의 97ms 지연은 놀랍습니다! 실시간 음성 어시스턴트에 통합했고 스트리밍 생성이 완벽하게 작동합니다. 음성 복제 품질이 뛰어납니다.
Rachel Kim
HeyBeauty.ai CTO
사전 구축된 AI 인프라는 게임 체인저입니다. 아키텍처에 대해 걱정할 필요 없이 AI 뷰티 기술에만 집중하고 빠르게 출시했습니다.
Marcus Thompson
개인 개발자
콘텐츠 크리에이터로서 Qwen3-TTS는 필요한 모든 것을 제공합니다 - 음성 복제, 다국어 지원 및 표현력 있는 음성 생성. 3초 복제 시간이 놀랍습니다!
Sofia Garcia
Melodisco CEO
템플릿은 프로덕션 준비가 되어 있고 고도로 커스터마이징 가능합니다. 수개월이 아닌 몇 시간 만에 AI 음악 플랫폼을 구축했습니다. 놀라운 출시 속도입니다!
James Wilson
GPTs.works 기술 리드
Qwen3-TTS의 오픈소스 특성과 포괄적인 문서로 통합이 원활했습니다. vLLM-Omni 지원 및 DashScope API 옵션은 배포에 유연성을 제공합니다.
Anna Zhang
스타트업 창업자
프로토타입에서 프로덕션까지 며칠 만에! Qwen3-TTS의 음성 복제 및 디자인 기능으로 빠르게 개인화된 음성 어시스턴트를 구축할 수 있었습니다. 오픈소스 라이선스는 우리 스타트업에 완벽합니다.
Qwen3-TTS에 대한 자주 묻는 질문
다른 질문이 있으신가요? GitHub Issues 또는 Hugging Face Discussions를 방문하세요.
Qwen3-TTS는 무엇이며 무엇이 다른가요?
Qwen3-TTS는 Alibaba Cloud의 Qwen 팀이 개발한 오픈소스 TTS 모델 시리즈입니다. 안정적이고 표현력 있는 스트리밍 음성 생성, 자유 형식 음성 디자인 및 생생한 음성 복제를 지원합니다. 주요 차별화 요소에는 초저지연(97ms), 자연어 기반 음성 제어 및 10개 주요 언어에 대한 포괄적인 다국어 지원이 포함됩니다.
Qwen3-TTS를 실행하려면 어떤 하드웨어가 필요하나요?
Qwen3-TTS 모델은 GPU 지원이 필요합니다. GPU 메모리 사용량을 줄이기 위해 FlashAttention 2를 사용하는 것을 권장합니다. 모델은 torch.float16 또는 torch.bfloat16으로 로드할 수 있습니다. 최적의 성능을 위해 충분한 VRAM이 있는 GPU를 사용하세요(8GB+ 권장). 모델은 로컬 하드웨어 요구 사항 없이 클라우드 기반 추론을 위해 DashScope API를 통해 사용할 수도 있습니다.
다양한 Qwen3-TTS 모델은 무엇이며 어떤 것을 사용해야 하나요?
Qwen3-TTS는 여러 모델을 제공합니다: CustomVoice(9가지 프리미엄 음색), VoiceDesign(설명에서 음성 생성) 및 Base(음성 복제). 사전 정의된 음성의 경우 CustomVoice를, 사용자 정의 음성 생성을 위해 VoiceDesign을, 또는 기존 음성을 복제하기 위해 Base를 선택하세요. 모든 모델은 스트리밍 생성 및 10개 주요 언어를 지원합니다.
Qwen3-TTS는 얼마나 빠르며 실시간 생성이 가능한가요?
Qwen3-TTS는 97ms의 엔드투엔드 합성 지연을 달성하여 실시간 대화형 시나리오에 적합합니다. 단일 문자 입력 후 첫 번째 오디오 패킷을 즉시 출력할 수 있는 스트리밍 생성을 지원하며, 혁신적인 듀얼 트랙 하이브리드 스트리밍 생성 아키텍처를 사용합니다.
Qwen3-TTS를 상업적으로 사용할 수 있나요?
네! Qwen3-TTS는 무료 상업적 사용을 허용하는 Apache-2.0 라이선스 하에 완전히 오픈소스입니다. 추가 라이선스 수수료 없이 배포, 수정 및 상업 프로젝트에 통합할 수 있습니다. 모델은 GitHub, Hugging Face 및 ModelScope에서 사용할 수 있습니다.
Qwen3-TTS로 어떻게 시작하나요?
가장 쉬운 방법은 PyPI에서 qwen-tts Python 패키지를 설치하는 것입니다. 깨끗한 Python 3.12 환경을 만들고, 패키지를 설치한 다음, 게시된 모델을 로드하세요. Hugging Face 또는 ModelScope의 온라인 데모를 시도하거나 클라우드 기반 추론을 위해 DashScope API를 사용할 수도 있습니다. 자세한 문서와 예제는 GitHub 저장소를 확인하세요.
오늘 Qwen3-TTS 사용 시작하기
무료로 온라인 체험. 97ms 초저지연과 표현력 있는 음성 생성을 경험하세요