免费在线体验 Qwen3-TTS 强大语音生成
无需登录 • 无需信用卡 • 立即开始使用
97ms 超低延迟 | 语音克隆 | 40+ 音色 | 10种语言 | 阿里云 AI
0 / 1000 characters
什么是 Qwen3-TTS
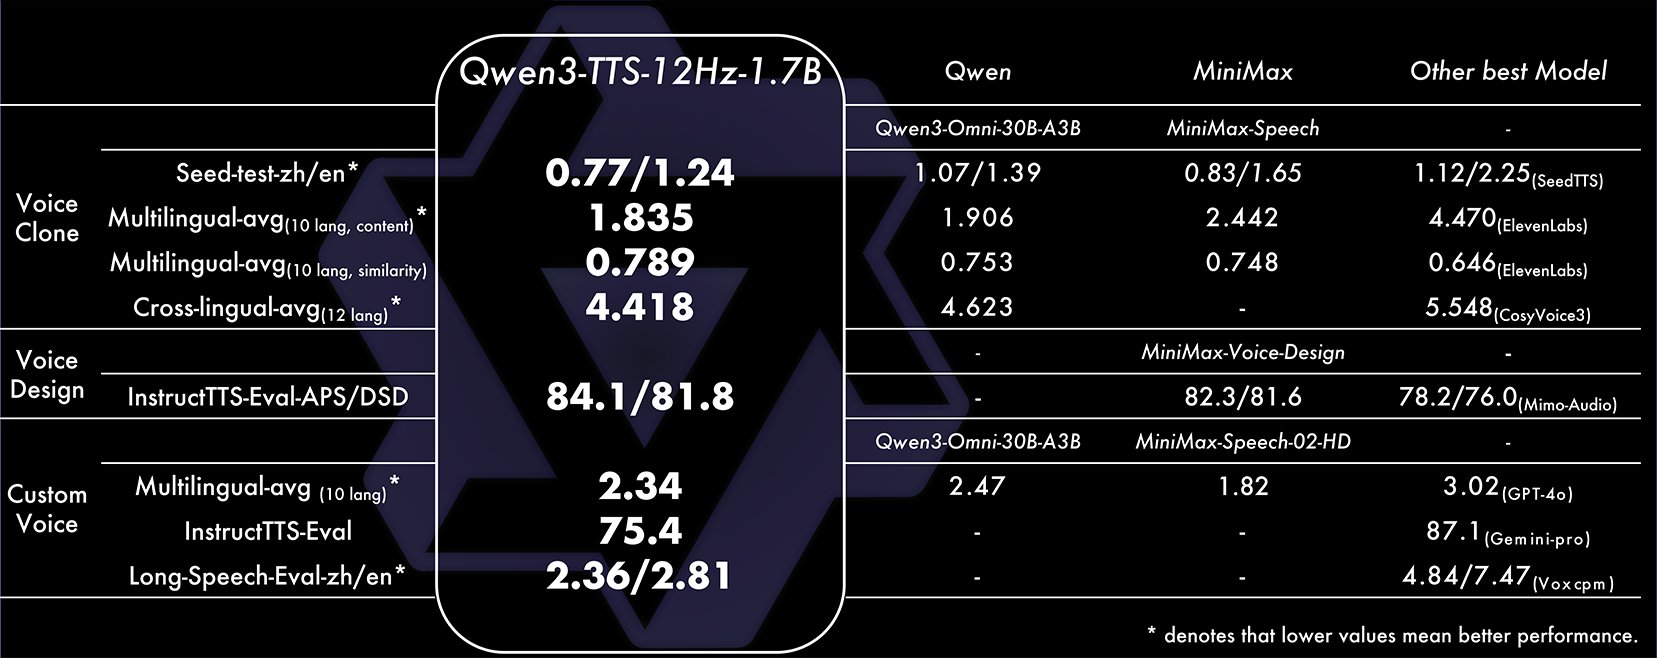
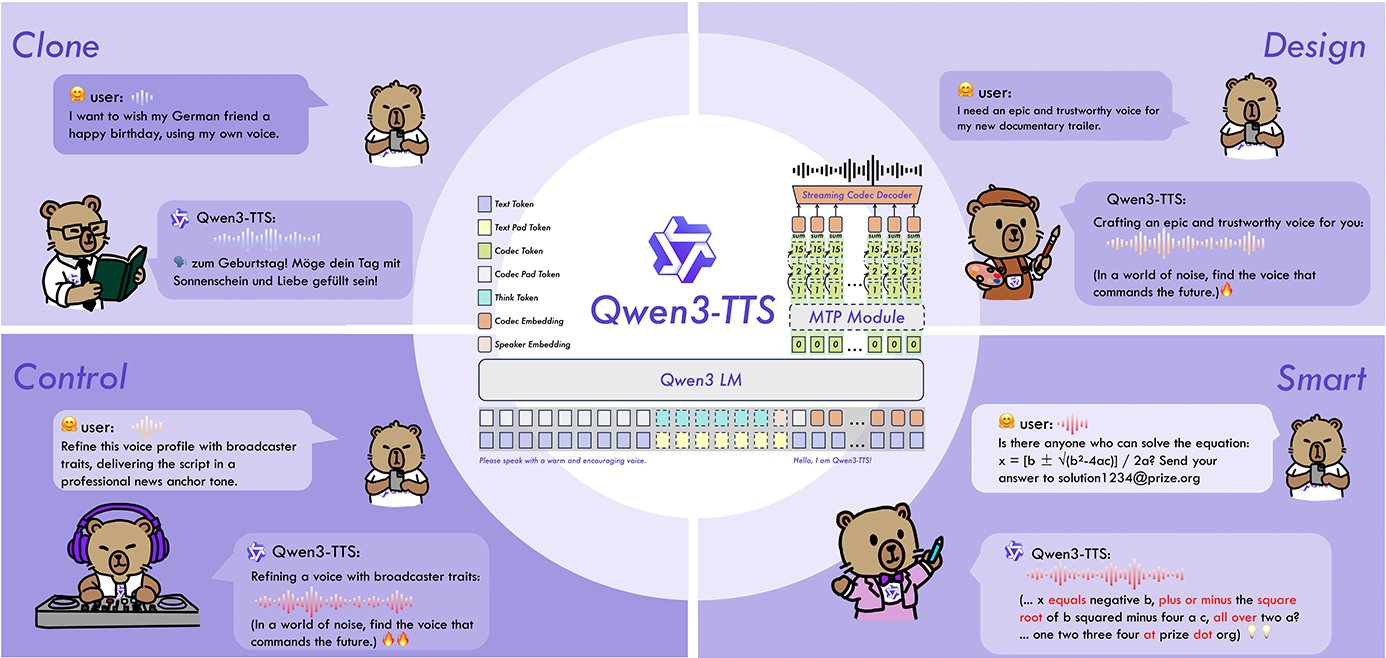
Qwen3-TTS 是通义千问团队开发的开源 TTS 模型系列,支持稳定、表达力强、流式语音生成,自由形式语音设计和生动的语音克隆。
- 语音克隆仅需3秒音频即可克隆任何声音。快速、准确的语音复制,适用于各种应用场景。
- 语音设计使用自然语言描述创建自定义语音。通过简单指令设计独特的语音特征。
- 超低延迟流式生成,端到端延迟低至97ms,完美适用于实时交互场景。
为什么选择 Qwen3-TTS
体验最全面的语音生成功能,从语音克隆到智能语音控制。
如何快速开始使用 Qwen3-TTS
通过四个简单步骤开始生成高质量语音:

Qwen3-TTS 核心功能
为开发者和用户提供的全面语音生成能力。
语音克隆
仅需3秒音频即可克隆任何声音。快速、准确的语音复制,适用于各种应用。
语音设计
使用自然语言描述创建自定义语音。通过简单指令设计独特的语音特征。
流式生成
超低延迟流式生成,端到端合成延迟97ms。单个字符输入后立即输出首个音频包。
多语言支持
支持10种主要语言:中文、英文、日文、韩文、德文、法文、俄文、葡萄牙文、西班牙文和意大利文。
自然语言控制
智能文本理解,基于指令自适应控制语调、语速和情感表达。
开源免费
完全开源,Apache-2.0 许可证,可免费商用。在 GitHub、Hugging Face 和 ModelScope 上可用。
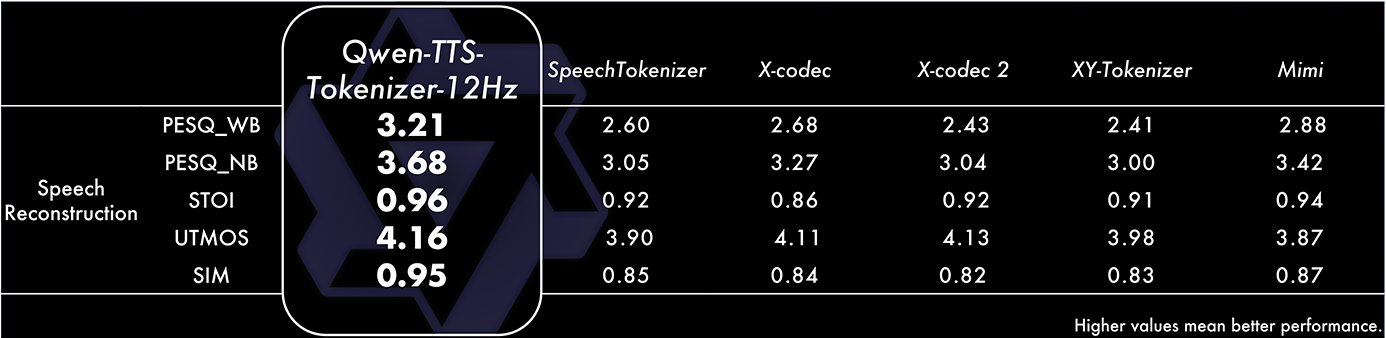
Qwen3-TTS 性能数据
行业领先的语音生成质量和速度指标。
端到端延迟
97ms
超低延迟
支持语言
10
主要语言
语音克隆时间
3秒
快速克隆
用户如何评价 Qwen3-TTS
听听使用 Qwen3-TTS 进行语音生成项目的开发者和研究人员怎么说。
李教授
AI 研究员
Qwen3-TTS 的97ms延迟太惊人了!我们将其集成到实时语音助手中,流式生成工作完美。语音克隆质量非常出色。
张工程师
VoiceTech 开发者
语音设计功能太强了!我们可以使用简单的自然语言描述为不同角色创建自定义语音。非常直观和强大。
王创作者
内容创作者
作为内容创作者,Qwen3-TTS 给了我所需的一切 - 语音克隆、多语言支持和表达力语音生成。3秒克隆时间太棒了!
刘产品经理
产品经理
我们将 Qwen3-TTS 集成到有声书平台。多语言支持和自然语言控制使其非常适合我们的全球受众。质量已达到生产级别!
陈技术负责人
技术负责人
Qwen3-TTS 的开源性质和全面的文档使集成变得无缝。vLLM-Omni 支持和 DashScope API 选项为部署提供了灵活性。
赵创业者
创业公司创始人
从原型到生产只需几天!Qwen3-TTS 的语音克隆和设计功能使我们能够快速构建个性化语音助手。开源许可证非常适合我们的创业公司。
关于 Qwen3-TTS 的常见问题
还有其他问题?访问 GitHub Issues 或 Hugging Face Discussions。
Qwen3-TTS 是什么?它有什么不同?
Qwen3-TTS 是通义千问团队开发的开源 TTS 模型系列。它支持稳定、表达力强、流式语音生成,自由形式语音设计和生动的语音克隆。主要区别包括超低延迟(97ms)、基于自然语言的语音控制和覆盖10种主要语言的全面多语言支持。
运行 Qwen3-TTS 需要什么硬件?
Qwen3-TTS 模型需要 GPU 支持。我们建议使用 FlashAttention 2 来减少 GPU 内存使用。模型可以以 torch.float16 或 torch.bfloat16 加载。为了获得最佳性能,请使用具有足够 VRAM 的 GPU(推荐 8GB+)。模型也可通过 DashScope API 进行云端推理,无需本地硬件要求。
有哪些不同的 Qwen3-TTS 模型?我应该使用哪个?
Qwen3-TTS 提供多个模型:CustomVoice(9种优质音色)、VoiceDesign(从描述创建语音)和 Base(语音克隆)。选择 CustomVoice 用于预定义语音,选择 VoiceDesign 用于自定义语音创建,或选择 Base 用于克隆现有语音。所有模型都支持流式生成和10种主要语言。
Qwen3-TTS 有多快?能否进行实时生成?
Qwen3-TTS 实现端到端合成延迟低至97ms,非常适合实时交互场景。它支持流式生成,在单个字符输入后可以立即输出首个音频包,使用创新的双轨混合流式生成架构。
可以商业使用 Qwen3-TTS 吗?
可以!Qwen3-TTS 在 Apache-2.0 许可证下完全开源,允许免费商业使用。您可以部署、修改并将其集成到商业项目中,无需任何额外的许可费用。模型在 GitHub、Hugging Face 和 ModelScope 上可用。
如何开始使用 Qwen3-TTS?
最简单的方法是从 PyPI 安装 qwen-tts Python 包。创建干净的 Python 3.12 环境,安装包,然后加载任何已发布的模型。您也可以尝试 Hugging Face 或 ModelScope 上的在线演示,或使用 DashScope API 进行云端推理。查看 GitHub 仓库获取详细文档和示例。
立即开始使用 Qwen3-TTS
免费在线体验 97ms 超低延迟和表达力语音生成